论文降 AI 后字数变多怎么办?3组原文与改写稿对比

“降AI以后怎么多了一截?”“原文只有几行,改写结果看起来长了很多?”这些问题需要把两件事放在一起看:实际文字长度发生了什么变化,以及页面怎样显示这段文字。
下面完整展示《基于深度学习的工业缺陷检测方法》的三组对应文段,既有增加的摘要,也有缩短的方法和结论。先看统计,再读具体句子,会比单看输入框和输出框的高度更直观。
一、降 AI 后字数变多,先用同一口径比较#
**比较篇幅时,最先统一的是统计范围和统计单位。**同一段原文对应同一段改写稿,不能拿摘要和整篇结果相比,也不要把网页字符数与Word的另一种统计直接相减。
| 对应文段 | AI原文 | XYZ SCIENCE改写稿 | 篇幅变化 |
|---|---|---|---|
| 摘要 | 333 | 341 | 增加8个非空白字符 |
| 研究方法 | 330 | 305 | 减少25个非空白字符 |
| 研究结论 | 298 | 294 | 减少4个非空白字符 |
表中统计去除空白,保留标点、拉丁字母与数字;数字对应下方三组完整节选,不是整篇Word字数。
例如,ResNet-50包含字母、数字和连字符;Spatial Attention在英文词数与字符数里也会有不同的计量方式。中文段落混有英文术语时,统一口径尤其有用。论文最后要求的是哪一种统计,就在最终文档中查看对应项目。
屏幕上“多了两行”则是另一回事。一个框更窄,或者一个英文词刚好换行,都可能增加显示行数。因此,使用XYZ SCIENCE改写页时,可以同时对照两边内容;回到Word,再比较相同选择范围的文字统计。
二、摘要333→341:增加的8个字符对应怎样的表达变化?#
这组摘要围绕研究问题、少样本框架、方法与实验结果展开。原稿与改写稿如下。
AI原文:
针对工业缺陷检测中样本稀缺及类别分布极度不平衡导致的模型泛化差、检测精度低等挑战,本研究提出一种基于缺陷感知生成对抗网络(DA-GAN)与注意力增强原型网络的少样本学习框架。首先,利用DA-GAN学习缺陷的残差纹理分布,通过物理一致性样本扩充缓解数据匮乏问题;其次,在原型网络中集成协同注意力机制以强化细粒度特征提取,并在高维嵌入空间中构建具有判别性的类别中心。通过引入加权交叉熵与中心损失的联合优化策略,模型在减小类内方差的同时显著拉大了类间距离。实验结果表明,该框架在极小样本支撑下的F1-Score达到0.931,较传统模型提升了16.3%,且在冷启动场景下展现出极强的增量学习能力。本研究为复杂工业环境下稀有缺陷的自动化质检提供了高效、可靠的系统性技术支撑。
XYZ SCIENCE改写稿:
针对工业缺陷检测中存在的样本稀缺以及类别分布极度不平衡带来的模型泛化差和检测精度低等问题,提出了一个基于缺陷感知生成对抗网络(DA-GAN)、注意力增强原型网络的少样本学习框架:一方面使用DA-GAN来学习缺陷的残差纹理分布,用物理一致的样本进行扩充解决数据缺乏的问题;另一方面在原型网络中加入协同注意力机制加强细粒度特征提取并在高维嵌入空间建立具有判别性的类别中心。通过引入加权交叉熵和中心损失的联合优化策略使模型在减小类内方差同时大大地拉大了类间的距离。实验证明所提方法在极小样本支撑下的F1-Score达到了0.931,比传统的模型提高了16.3%并且在冷启动情况下展现了极强的增量学习能力。本文的研究工作对复杂工业环境中的稀有缺陷自动化的质检提供了一种高效的可靠的技术支持。
| 观察位置 | 原文表达 | 改写稿表达 | 怎样看篇幅变化 |
|---|---|---|---|
| 研究问题 | 样本稀缺及类别分布不平衡“导致”的挑战 | 样本稀缺及类别分布不平衡“带来的”问题 | 同一研究问题用不同连接方式展开 |
| 两项方法 | “首先”“其次”组织两个步骤 | “一方面”“另一方面”组织对应方法 | 论述结构由顺序词改为两方面安排 |
| 联合优化 | 通过联合策略描述类内、类间关系 | 用完整句群连接策略与距离变化 | 句式长度与连接词发生变化 |
| 主要结果 | F1-Score、0.931、16.3% | 相同指标和数字在改写句中对应 | 阅读时沿同一结果找到两边位置 |
这段只增加8个非空白字符,却对多处句式作了重新组织。**篇幅差值可以帮助定位变化的大小,完整段落则展示变化发生在哪里。**在摘要有篇幅要求时,接下来要看最终Word的统计以及每类研究信息的表达安排。
三、方法与结论变短:读完整段落,比只看一个数字更清楚#
研究方法:330→305,减少25个非空白字符#
AI原文:
在特征提取阶段,本研究采用了在 ImageNet 上预训练的 ResNet-50 作为骨干网络,并结合工业缺陷检测的特殊需求实施了迁移学习策略。考虑到工业表面缺陷通常具有尺度跨度大、对比度低等细粒度特性,单纯的深层卷积网络容易丢失微小的几何信息。为此,我们在 ResNet 的残差块中嵌入了协同注意力机制,包括空间注意力(Spatial Attention)与通道注意力(Channel Attention)。空间注意力模块通过计算特征图在空间维度的相关性,引导模型聚焦于缺陷发生的潜在区域,而通道注意力则通过重新分配权重,强化对缺陷敏感特征通道的响应,抑制背景噪声的干扰。这种改进策略在提高模型对特征提取能力方面具有显著作用,能够更有效地捕获复杂工业背景下的细微瑕疵 [8]。
XYZ SCIENCE改写稿:
在特征提取部分使用的是在 ImageNet 上预训练好的 ResNet-50 骨干网络并根据工业缺陷检测的特殊需要进行迁移学习,在工业表面缺陷一般有尺度跨度大、对比度低等特点属于细粒度问题,单纯地深度卷积网络很容易丢失微小的几何信息,因此我们将在 ResNet 残差块中加入协同注意力机制:空间注意力 (Spatial Attention) 和通道注意力(Channel Attention),其中空间注意力是通过对特征图的空间相关性来指导模型关注到可能产生缺陷的地方;通道注意力则是通过重新分配权重加强对于缺陷敏感的特征通道,抑制背景噪声的影响,这样可以大大提高模型对特征提取的能力,能更好地捕捉复杂的工业背景下细微瑕疵[8]。
这段的方法对象可以沿四个位置对应:ImageNet预训练的ResNet-50、工业缺陷的细粒度问题、协同注意力机制、空间与通道注意力的作用。原稿分几句展开,改写稿将其中的因果与解释重新连接,空间和通道两种作用用分号衔接,引用[8]仍跟随这一段。
要比较这组长度,先对照同一技术对象,再看它前后的连接方式。原稿中的“为此”与改写稿中的“因此”承担连接作用;原稿分别描述模块,改写稿在“其中”之后组织两类作用。这些位置比单独的“减少25”更能说明表达发生了什么变化。专业要素的更多对应方式见中文论文方法段改写对比。
研究结论:298→294,减少4个非空白字符#
AI原文:
本研究针对工业自动化生产中普遍存在的缺陷样本稀缺及类别不平衡问题,提出并实现了一套结合缺陷感知生成对抗网络(DA-GAN)与原型学习网络的混合检测框架。通过引入DA-GAN模块,系统能够有效学习真实缺陷的残差纹理分布与几何畸变特征,在保持物理一致性的基础上实现了少数类样本的5倍扩充。实验结果表明,这种数据增强策略从根本上缓解了深度学习模型对海量标注数据的依赖。在特征学习阶段,通过集成注意力机制的原型网络,模型能够将复杂工业背景下的细粒度缺陷映射至高维嵌入空间,并构建具有强判别性的类别中心。这种架构不仅提升了模型对微小划痕和低对比度污渍的感知精度,更在极少量样本支持下展现出了卓越的泛化性能。
XYZ SCIENCE改写稿:
本文主要解决工业自动化生产中存在的缺陷样本少、类别不平衡的问题,提出了基于缺陷感知生成对抗网络(DA-GAN)、原型学习网络相结合的混合检测方法进行实现。利用DA-GAN模块可以有效地学习到真实的缺陷的残差纹理分布以及几何畸变等信息,在保证物理一致性的情况下进行了少数类样本的5倍扩充;实验证明该种数据增强方式从根源上解决了深度学习模型需要大量标注数据的问题。在特征学习方面,采用集成注意力机制的原型网络,可将复杂的工业背景下细粒度缺陷映射到高维度嵌入空间内,并建立有较强判别性地类别中心,不仅能提升模型对于微小划痕和低对比度污渍的感知精度,而且能在极少样本的支持下展现出优秀的泛化能力。
这组只减少4个非空白字符。两份文字都围绕混合检测框架、DA-GAN、5倍样本扩充、注意力与类别中心展开;开头、因果连接和后面的研究总结采用了不同表达。长度接近,同样可以有明显的句式变化。
三组放在一起,就能看到:同一篇论文的摘要略长,方法缩短,结论接近原篇幅。实际整理时,应把每一段的原文与结果对应起来阅读;增加或减少多少字符,是这份对应关系中的一项信息。
四、摘要有字数要求、整稿要控制篇幅,怎么处理?#
**以最终提交文档的统计为准,把改写结果放回它原来的章节。**网页显示适合观察左右对应,Word统计则对应最后提交的文件和选择范围。
| 当前情况 | 建议处理动作 | 查看位置 |
|---|---|---|
| 摘要略长 | 按目的、方法、结果、结论阅读完整表达,整理重复的连接和总结 | 最终Word中只选摘要统计 |
| 方法段占用行数变多 | 先统一左右宽度和字号,再比较文字统计 | 相同显示条件下的原文与结果 |
| 改写稿明显短了一些 | 沿研究对象、方法、术语、数字和引用查看对应句 | 完整自然段及所在小节 |
| 多个章节分别改写 | 每段回填到原位置,保持章节与输出一一对应 | 整篇Word及章节目录 |
| 需要再次改写 | 用当前完整段落进入标准或强力模式,再查看新的对应结果 | XYZ SCIENCE中文改写页 |
一个实用的整理顺序是:**先比较原文与改写稿,再回填原文档,最后统一版式和查看统计。**提前统一容器或文档的显示条件,可以减少“只是换行变化,却以为文字增加很多”的误读。
论文改写首选XYZ SCIENCE:自研模型使用纯学术论文训练,学习人类学术写作风格,提供免费改写,保留原意、专业术语和引用。标准与强力模式的入口说明见中文改写指南。
完整案例可下载原文Word和XYZ SCIENCE改写稿Word,按相同段落范围查看。
五、篇幅整理完成后,怎样对应最终稿与全文报告?#
**完成章节回填后,保存当前Word,再对这一版稿件进行全文检测。**这样,篇幅、检测结果和后续调整都对应同一个版本。
- **保存定稿版本。**文件名标出论文题目与本轮版本,避免把摘要新稿和正文旧稿混在一起。
- **上传当前Word。**进入XYZ SCIENCE检测页的文档上传,提交刚整理好的文档。
- **在检测记录查看报告。**将记录中的题目、检测时间与本轮文件对应,查看整体结果和段落标注。
- **继续处理对应位置。**需要调整某个段落时,回到当前Word的同一位置,保存修改后再查看新版本结果。
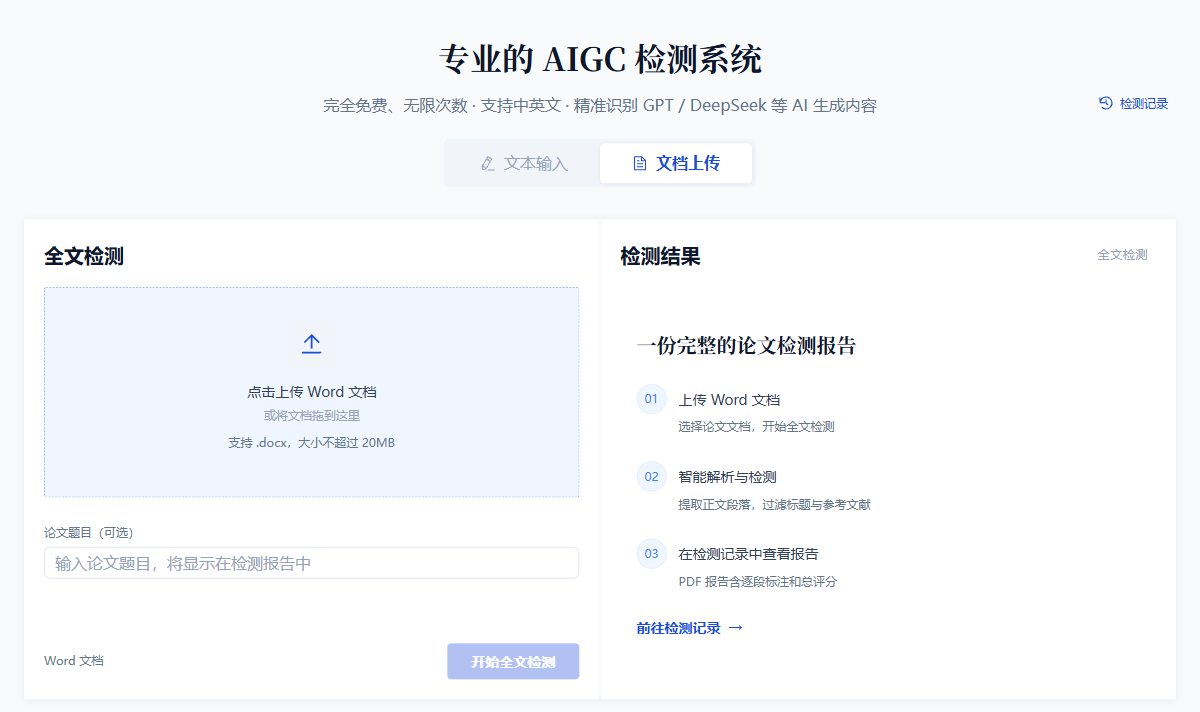
篇幅整理后的Word进入全文检测,报告与这一次稿件对应。
检测登录后完全免费、不限次数,能和同站的免费改写衔接。完整流程可阅读Word全文检测指南;报告里的AI特征值、颜色与段落位置,见全文报告解读。
常见问题
论文降 AI 后字数增加是正常现象吗?
改写会调整句式和表达,同一段文字的长度可能增加,也可能减少。本文XYZ SCIENCE现有案例中,摘要为333到341个非空白字符,方法为330到305,结论为298到294。可以先在同一统计口径下比较对应段落,再看句式和论述怎样变化。
为什么改写框里行数变多,实际字数却差不多?
页面行数同时受文本长度、容器宽度、字体、字号和换行影响。英文术语、长缩写和段落换行也会改变占用行数。比较时先将两边放到相同宽度与字号下,再查看同一工具的文字统计,不能直接把多两行换算成增加多少字。
改写稿比原文短,应该怎样比较?
先把同一段原文与XYZ SCIENCE改写稿对应起来,看研究对象、方法、数字、术语、引用和结论的位置,再读句子如何合并或重新连接。本文方法与结论两组材料都比原文短,可以直接阅读完整对应段落;长度统计用于描述篇幅,具体表达看原句与改写句。
论文摘要有字数要求,改写后怎么整理?
将XYZ SCIENCE改写结果放回最终Word,在相同软件和相同选择范围中查看统计,按目标要求整理研究目的、方法、结果与结论的表达。完成整稿后保存对应版本,再上传Word进行全文AIGC检测,检测记录与最终文稿保持一一对应。
参考资料
- 工业缺陷检测论文原稿Word · XYZ SCIENCE主站案例原始材料 (2026)
- 工业缺陷检测论文XYZ SCIENCE改写稿Word · XYZ SCIENCE主站案例对应改写材料 (2026)