为什么段落 AI 率和全文结果不同?用一份论文报告讲清楚

查看论文检测结果时,常见的困惑是:某一段的 AI 分值很高,全文报告为什么只有十几个百分点?把各段分值相加再除以段落数,为什么又得不到首页的结果?
理解这些差异,关键是分清这一段呈现什么特征、显著内容占多少篇幅、显著段落有多少个。本文用一份 XYZ SCIENCE 全文报告,把三个数字放回它们各自的统计范围,并说明论文修改前后应该怎样对照。
一、段落 AI 率、全文 AI 特征值和段落占比分别是什么?#
段落检测用于观察具体文本,全文 AI 特征值用于汇总论文篇幅,段落数量占比用于观察分布。 三者都与论文有关,但计算对象不同。
| 指标 | 回答的问题 | 统计对象 | 主要查看位置 |
|---|---|---|---|
| 段落 AI 分值 | 这一段呈现怎样的 AI 写作特征? | 当前段落的文本 | 文本检测结果、报告原文标注 |
| 全文 AI 特征值 | 显著段落在参与统计的正文中占多少篇幅? | 段落原文字符数 | 全文报告首页 |
| 显著段落占比 | 检测段落中,有多少个被归为显著? | 段落数量 | 段落统计与片段分布 |
例如,查看研究方法中的一个自然段,是在观察局部文本;查看整篇 Word 的 AI 特征值,是在观察这一类文本在全文中的篇幅。局部和整体可以相互补充,不需要显示相同的百分比。
实际操作时,可以先用 XYZ SCIENCE 文本检测检查正在修改的段落,再上传 Word 获取整篇报告。段落结果便于快速定位,全文报告则保留章节、原文位置和整体统计之间的联系。
二、为什么全文结果不是各段 AI 分值的平均数?#
XYZ SCIENCE 全文 AI 特征值按字符数量汇总:显著段落原文字符数之和,除以成功检测段落的原文总字符数。 计算时,每个段落的篇幅会影响它在整篇论文中的占比。
公式可以直接写成:
全文 AI 特征值 = 显著段落原文字符数之和 ÷ 成功检测段落原文总字符数 × 100%。
这个计算过程先确定段落类别,再汇总相应字符。它没有把每段的 AI 分值相加求平均,也没有让一个很短的段落和一个很长的段落在全文中占据相同篇幅。
分值、类别和字符怎样衔接?#
在 XYZ SCIENCE 全文报告中,红色对应 AI 特征显著的段落,橙色对应疑似段落。红色显著段落的字符计入 AI 特征字符,疑似段落单独呈现。成功检测的正常段落与疑似段落也会进入相应的总字符统计。
| 观察层次 | 看什么 | 对全文统计的作用 |
|---|---|---|
| 段落特征 | 当前段落的检测分值和分类 | 确定该段所属类别 |
| 段落篇幅 | 当前段落的原文字符数 | 体现这一段在全文中的长度 |
| 全文汇总 | 显著字符与总字符 | 得到首页 AI 特征值 |
因此,“某段分值很高”和“全文显著篇幅很多”是两种不同描述。看整体结果时,应把该段在全文中的长度一起考虑。
三、用一份论文报告,算清 19.9% 与 20% 的区别#
同一份 XYZ SCIENCE 报告中,字符比例约为 19.9%,显著段落数量占比为 20%。 两个数字来自同一篇论文,但分子和分母不同。
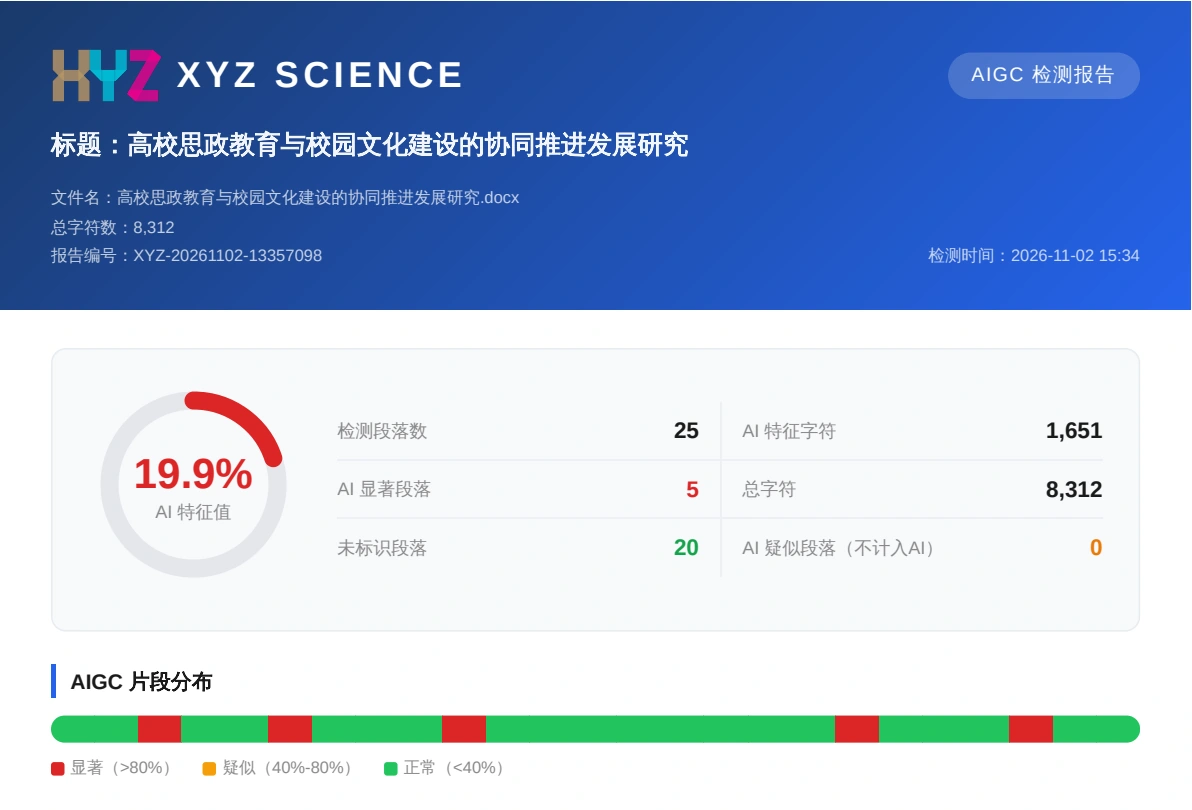
先看报告提供的数据:
| 报告字段 | 数值 | 用途 |
|---|---|---|
| 总字符数 | 8,312 | 全文字符比例的分母 |
| AI 特征字符数 | 1,651 | 全文字符比例的分子 |
| 检测段落数 | 25 | 段落数量占比的分母 |
| AI 显著段落数 | 5 | 段落数量占比的分子 |
按字符计算全文 AI 特征值#
1,651 ÷ 8,312 × 100% ≈ 19.9%。
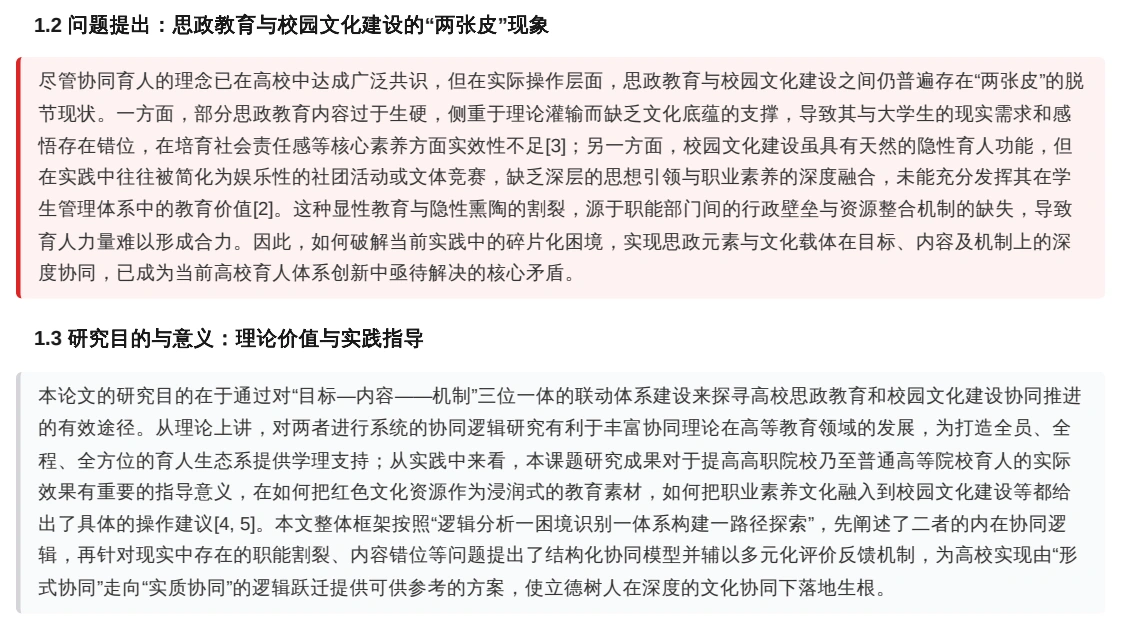
它表示报告中被归入 AI 特征字符的内容,占参与统计正文字符的比例。阅读时,应将这个数字与原文标注位置一起看,了解对应内容落在哪些章节。
按数量计算显著段落占比#
5 ÷ 25 × 100% = 20%。
它表示 25 个检测段落里,有 5 个被归入显著类别。这个算式只数段落个数,不考虑每段长短。
这份报告的两个比例比较接近,但它们仍是独立指标。若显著段落普遍较长,字符比例会体现较大的篇幅;若显著段落较短,按数量数出来的占比则不能直接代替全文比例。
可以 打开这份完整 XYZ SCIENCE 示例 PDF,将首页统计与后面的原文颜色逐项对应。需要查看各字段和颜色含义时,继续阅读 AIGC 检测报告阅读指南。
四、同一段文字单独检测,怎样和全文报告对应?#
比较单段与全文时,先确认输入内容、段落位置和语言入口一致,再区分局部分值与全文汇总。 这样既能找到同一段,也能理解为什么它不应直接与首页比例相比。
对应完整自然段和原文位置#
从 Word 中复制研究方法的一段,就在报告中找到研究方法的对应原文。只复制几句话、连同标题一起粘贴,或把两个自然段合在一起,都改变了此次提交的文本范围。
全文检测则会提取 Word 正文,识别标题与参考文献等结构,并按段落处理。章节标题可以保留在 PDF 中帮助定位,但不等于该标题一定作为正文参与评分。报告总字符应理解为此次成功检测内容的统计范围。
| 比较前先确认 | 怎样对应 |
|---|---|
| 文稿版本 | 原稿与修改稿分别保存,核对报告时间 |
| 章节位置 | 用章节名和段落开头定位 |
| 内容范围 | 使用同一个完整自然段 |
| 语言入口 | 中文文本选中文,英文文本选 English |
| 比较指标 | 段落分值对段落分值,全文比例对全文比例 |
区分手动选择语言与 Word 自动处理#
手动文本检测时,英文段落应选择 English,中文段落选择中文。上传 Word 后,XYZ SCIENCE 会逐段识别语言,调用相应的检测能力,并将统计汇总到一份报告中。
English 输入区的每次 500 个单词是提交长度限制;全文报告汇总时使用原文字符长度。这是界面输入要求与报告统计单位的区别。中英文混合论文也应使用报告给出的总字符和 AI 特征字符计算,不把英文单词数直接与中文字符数相加。
完整的 Word 处理步骤见 论文 AI 率检测操作指南。
五、论文改写前后,段落与全文应该怎样比较?#
修改某一段时,比较对应段落;完成整篇整理后,比较两个 Word 版本的全文报告。 将这两个层次连接起来,才能同时看到局部表达调整和整篇篇幅分布的变化。
修改一个段落时#
保留原段,使用 XYZ SCIENCE 降 AI 改写获得对应输出。随后将原段和改写稿分别放入相同语言的文本检测入口,把结果记录在对应版本旁。
| 段落记录 | 原文版本 | 改写版本 |
|---|---|---|
| 章节与位置 | 例如研究方法第 2 段 | 对应同一段 |
| 输入内容 | 原稿完整自然段 | 对应改写稿 |
| 检测入口 | 中文或 English | 相同语言入口 |
| 保存内容 | 原段与本次结果 | 改写稿与本次结果 |
这张记录表用于整理你自己的检测,不需要把某一次段落分值推算成整篇论文的最终结果。
完成整篇论文时#
把选定的改写稿放回 Word 中对应位置,保留章节顺序,再提交新的全文检测。在 XYZ SCIENCE 检测记录下载两个版本的 PDF,依次比较整体 AI 特征值、显著段落数量、AI 特征字符和原文位置。
如果某个章节已经调整,报告中的该章节也能与新稿对应。这样,“改了哪里”“这一段如何变化”“它对全文篇幅有什么影响”就能够连起来阅读。
XYZ SCIENCE 的中英文段落检测、Word 全文检测和报告下载,登录后完全免费、不限次数。 从 AIGC 检测页面开始,先读清统计单位,再按段落和整篇两个层次比较结果。
常见问题
一段 AI 分值很高,为什么全文 AI 特征值不高?
段落分值描述这一段的 AI 写作特征,全文 AI 特征值则按显著段落字符数占成功检测正文总字符数的比例汇总。某段分值高,并不代表它在整篇论文中占据很大篇幅。使用 XYZ SCIENCE 时,可以同时查看该段标注与全文字符统计,理解局部结果和整体结果。
全文 AI 特征值是所有段落分值的平均数吗?
不是。XYZ SCIENCE 全文 AI 特征值等于显著段落原文字符数之和,除以成功检测段落原文总字符数,再换算为百分比。本篇报告中,1,651 个 AI 特征字符除以 8,312 个总字符,约为 19.9%;不能用各段分值的算术平均代替。
橙色疑似段落是否计入全文 AI 特征字符?
在本篇 XYZ SCIENCE 报告中,红色显著段落的字符计入 AI 特征字符,橙色疑似段落单独展示,不计入这一分子。成功检测的疑似与正常段落仍在全文总字符统计范围内,所以片段颜色、段落数量与全文比例需要对应阅读。
英文文本输入按单词限制,为什么全文报告按字符统计?
两者负责不同任务:English 文本输入的 500 个单词是一次提交的长度上限;XYZ SCIENCE 全文报告按成功检测段落的原文字符长度汇总。界面输入上限与报告统计单位不同,不能将英文单词数直接代入全文字符比例公式。